| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- ps
- 코복장
- populating next right pointers in each node
- 백준
- 힙 정렬
- 부분수열의 합2
- 코딩테스트
- 샤논 엔트로피
- dfs
- T tree
- 구현
- 딥러닝
- BFS
- lgb
- 모두의 꿈
- 실질적 약수
- 코테
- 다이나믹 프로그래밍
- dp
- 아니메컵
- 17070
- 2247
- python
- 27448
- 파이썬
- 스펨메일 분류
- C
- 코딩
- 정답코드
- 정렬
- Today
- Total
코딩복습장
Score Matching 본문
지난 시간에는 생성모델이 나오게 된 이론적 원리와 Score fuction을 예측하게 된 배경에 대해서 설명했다.
이번 시간에는 Score Matching을 어떻게 하는지 설명해보겠다.
시작~~
Score function
score function이란 log-likelihood의 gradient를 의미한다.
score matching은 실제 probability density function을 구하는 것이 아닌 score값을 이용하여 probability funciton을 추정하는 것을 의미한다. 이러한 score matching기법은 최근 SDE를 활용하여 diffusion model을 모델링할 때, 널리 활용된다.
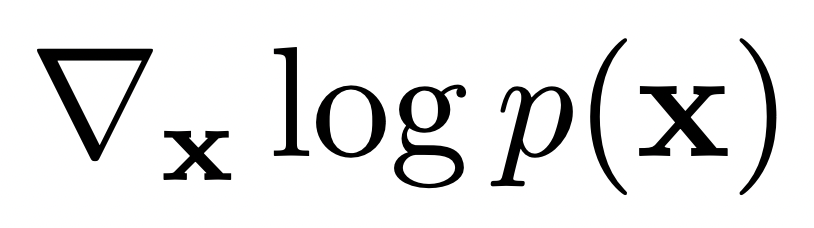
이를 식으로 표현하면 다음과 같다.
우리가 probability density function $p(x)$를 다음과 같이 parameterize된 형태로 정의한다고 가정해보자.
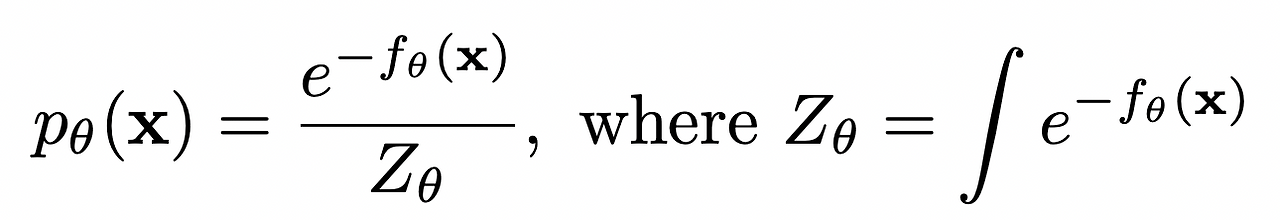
이렇게 정의되었을 때, constant $Z_{theta}$는 굉장히 복잡한 적분을 통해서 구해야 하기 때문에 계산이 쉽지 않다.
하지만 score function을 활용하여 log likelihood를 계산한다면 이 constant부분은 날아가게 되어 계산이 쉬워진다.
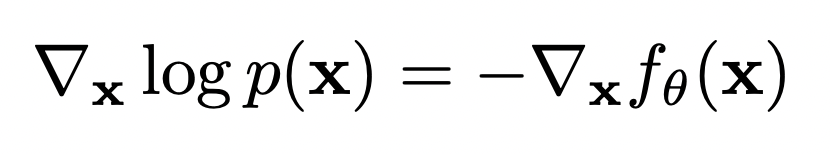
따라서 score matching을 하는 이유가 probability density function의 log likelihood를 통해 계산하는 것은 계산이 복잡하기 때문에 score funciton을 예측하는 방법을 사용한다고 정리할 수 있겠다.
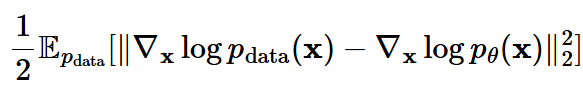
결국 실제 데이터의 score function과 예측한 socre function간의 차이를 최소화 하는 것이기 때문에 loss는 다음과 같이 구성될 것이다.
하지만 우리는 실제 데이터 분포를 정확하게 알지 못하기 때문에 이 형태의 loss를 사용하는 것은 불가능하다.
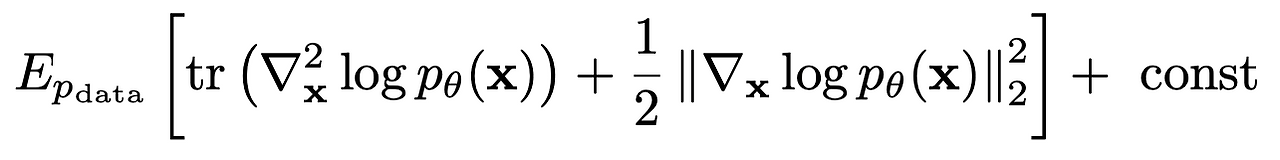
따라서 부분적분을 활용하여 위 수식을 다룰 수 있는 부분 + 상수 형태로 변형한다.
증명과정:

완전제곱식을 전개한다.
이후 첫 번째 항은 $p_{data}$가 포함되어 있기 때문에 우리가 다룰 수 없다. 따라서 생략한다.
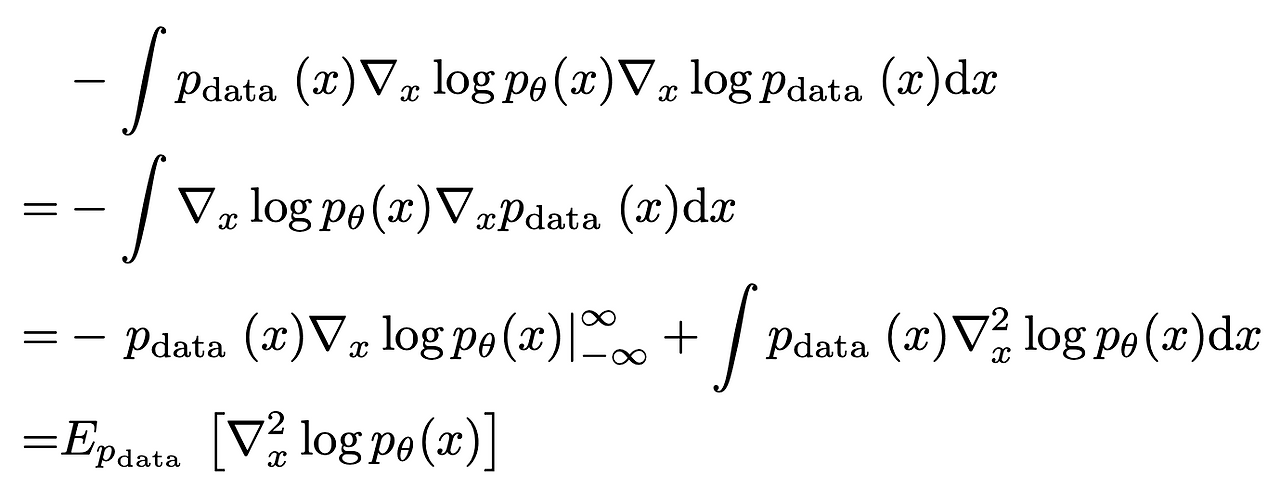
이후 두 번째 수식은 곱의 미분을 활용하여 수식을 변형시킨다.
$ \int f g^{' }= f g - \int f^{'} g $를 활용하는 것이다.
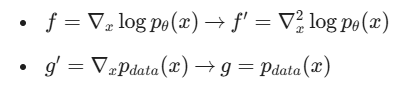
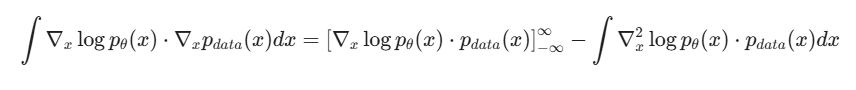
이 때 첫 번째 항은 $p_{data}(x)$의 x가 무한대로 갈 때(음의 무한대도 포함), 0으로 수렴하기 때문에 두 번째 항만 남는다고 한다.
이 부분은 잘 이해가 안간다..
이후 해당 부분을 넣어서 수식을 정리해보면
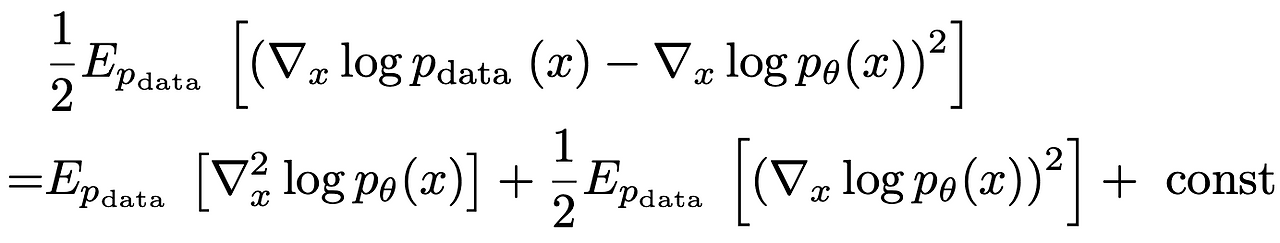
최종결과가 나오게 된다.
이렇게 loss를 tractable한 값만 포함하여 다룰 수 있도록 만들었고 이 식이 score matching의 objective가 된다.
이번 글에서는 score matching이 무엇인지 알아보았다.
이후에는 score based diffusion에 대해서 리뷰해보겠다.