| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- T tree
- 샤논 엔트로피
- dp
- BFS
- dfs
- 코딩
- 부분수열의 합2
- 코딩테스트
- 다이나믹 프로그래밍
- 힙 정렬
- 코복장
- 딥러닝
- 정답코드
- populating next right pointers in each node
- 27448
- 코테
- 2247
- 아니메컵
- 스펨메일 분류
- 실질적 약수
- 구현
- python
- 모두의 꿈
- 백준
- lgb
- 정렬
- ps
- 파이썬
- 17070
- C
- Today
- Total
코딩복습장
[CS231n] 7강 신경망 훈련하기(1/4) 본문

지난시간에 우리는 activation에 대해서 이야기를 했었다.
시그모이드와 tanh의 경우 활성함수의 양 끝에서 기울기가 사라지는 문제가 있었다.
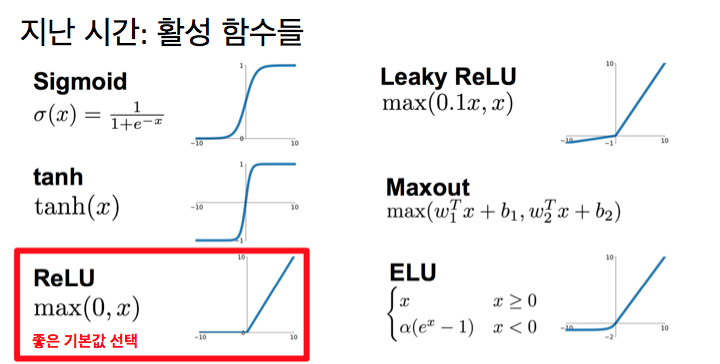
따라서 일반적으로 추천하는 방식은 ReLU를 쓰는 방식이다.
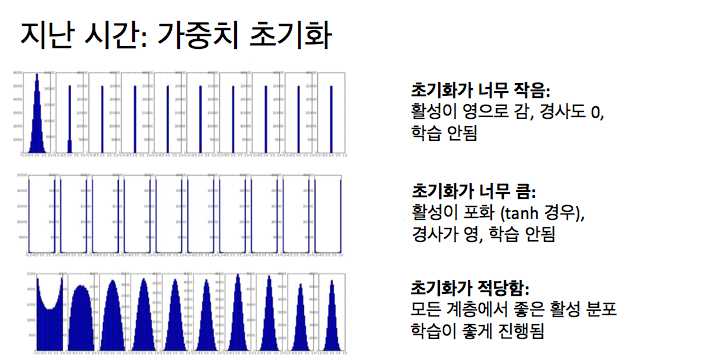
가중치 초기화에 대해서도 이야기 했었다.
가중치가 너무 작게 초기화 되어있다면 가중치들은 0을 향해 갈 것이다. (반복해서 작은 숫자를 곱해 나가기 때문)
반면에, 가중치를 너무 크게 초기화 하면 망을 겨쳐가면서 가중치 행렬을 계속 곱해 결국 폭발하게 된다.
이렇게 된다면 학습을 할 수 없게 된다. (weight가 올바른 방향으로 업데이트되지 않음)
그러나 초기화를 알맞게 Xavier 초기화를 사용하면 좋은 활성 분포를 유지하면서 망을 거쳐가게 될 것이다.
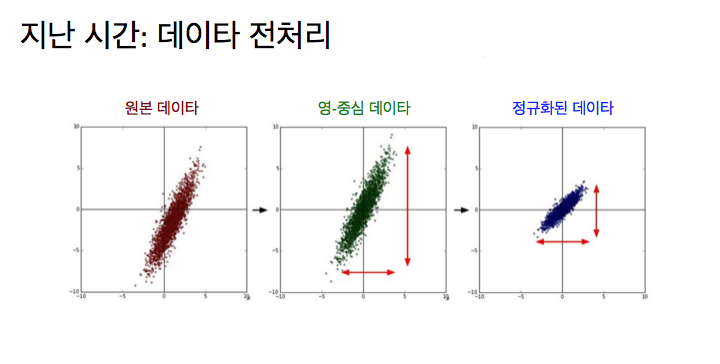
지난시간에는 데이터 전처리에 대해서도 이야기를 했다.
합성곱 망에서 0을 중심으로 맞추고 데이터를 normalization해서 평균을 0, 단위 분산을 가지도록 하는 것이 꽤 일반적이라고 이야기 했다.
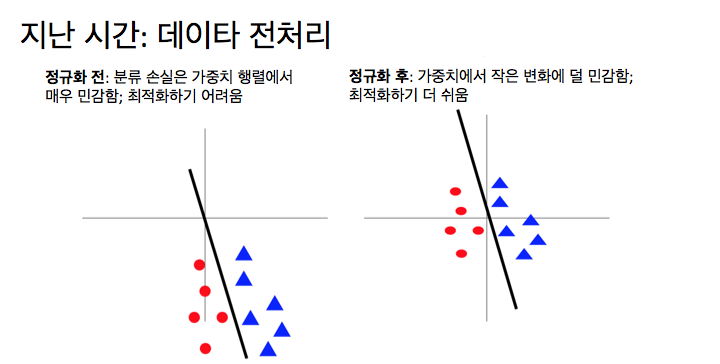
이 그림에서 왜 그런지 약간의 직관을 얻을 수 있다.
정규화 되기 전의 데이터의 분포가 평균이 0 이 아니라면 loss는 가중치 행렬에 대해 민감하게 된다.
-> 가중치가 조금만 바뀌어도 값이 아예 달라지게 된다.
정규화된 데이터에 대해서는 가중치의 작은 변화에 덜 민감해진다.
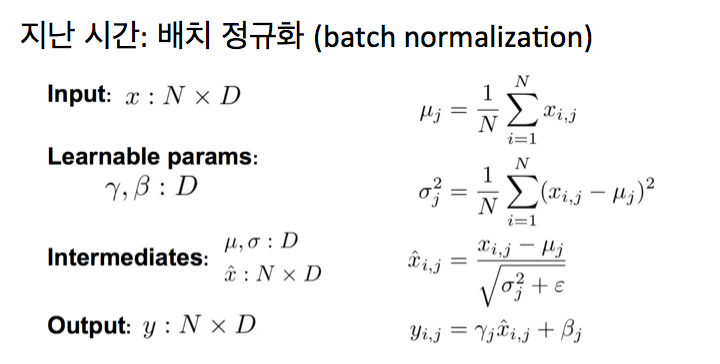
따라서 이 직관을 가지고 batch normalization을 적용했다.

우리는 지난시간에 training process를 베이비 시팅하는 과정을 이야기 했다.
훈련기간 동안 loss 함수 곡선을 어떻게 바라볼지에 대해 배운 것이다.
training 정확도가 계속 높아지지만, validation정확도가 잘 오르지 않는다면 과적합되었다고 볼 수 있다.
또한 traning동안 loss가 잘 내려가지 않고 평평한 구간을 만났을 때도 overfitting되었다고 볼 수 있다.
이 경우에는 regularization항을 추가할 수 있다.
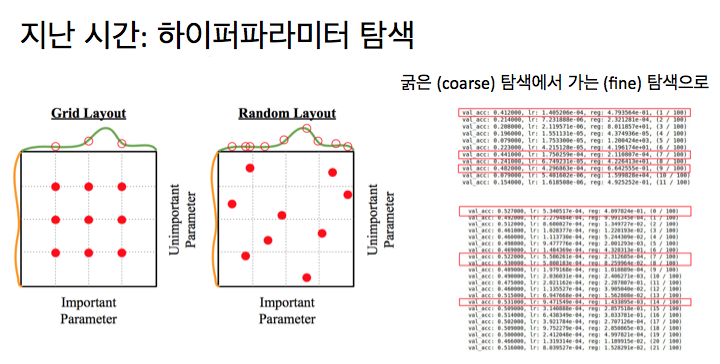
우리는 또한 하이퍼 파라미터 탐색에 대해서 이야기 했었다.
모든 망들은 일종의 커다란 파라미터 zoo를 형성한다고 볼 수 있다.
그리고 이러한 zoo를 어떻게 탐색하는지 두 가지 방법을 살펴봤다.
첫 번째 방법은 Grid search방법, 두 번째 방법은 Random search방법이다.
그림에 나타난 상황에서는 중요한 파라미터에 대해서 random search방식이 해당 파라미터 공간을 더 잘 커버하는
것을 볼 수 있다.
우리는 이러한 search방법을 사용하여 굵은(coarse)한 탐색에서 미세한(fine) 탐색으로 이동하는 아이디어를 이야기했다.
오늘 이야기할 부분은 정규화와 전이학습에 대한 내용이다.
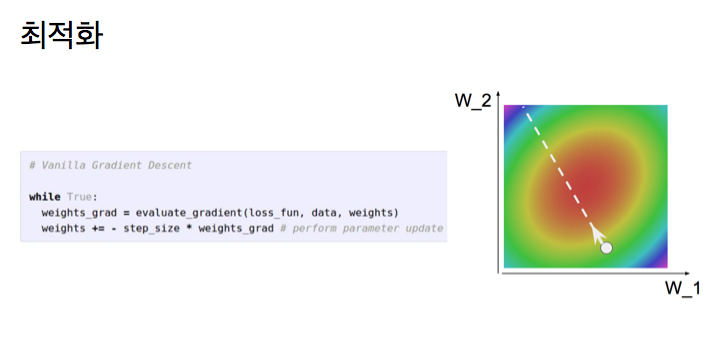
신경망을 학습시키는 핵심 전략은 최적화 문제라고 볼 수 있다.
우리는 손실 함수를 작성하고, 그 함수는 가중치의 값들이 우리의 문제에 대해 얼마나 좋은지 나쁜지를 얘기해준다.
이 손실함수는 우리에게 가중치에 대한 landscape을 준다고 생각할 수 있다.
목표는 빨간 지점(loss가 낮은 지점)의 weight를 찾는 것이다.
지금까지 우리는 극도로 단순한 최적화 알고리즘만을 살펴봤다. (확률적 경사하강법)
이런 간단한 최적화 방식은 실제에서 발생할 수 있는 많은 문제가 있다.

손실이 한쪽 방향으로만 빠르게 변하고 다른 방향으로는 느리게 변한다고 가정해보자..
이 경우에 손실 지형이 타코 쉘처럼 생겼다고 볼 수 있다.
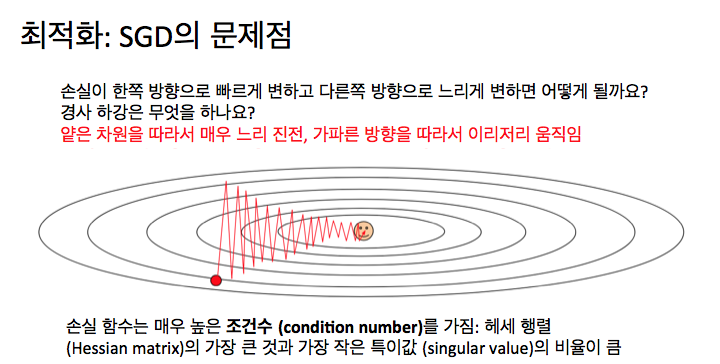
여기서 경사 하강법을 사용한다면 경사가 가파른 방향에 대해서는 크게크게 움직여서 지그재그로 음직이게 된다.
반면 경사가 약한 방향으로는 조금씩 움직여 느린 수렴을 하게 된다.
이러한 상황은 고차원에서 훨씬 많아지게 된다.
그리고 SGD의 성능도 잘 나오지 않는다.

매우 고차원으로 가면 local minima 문제보다 saddle point에 대한 문제가 더욱 많아진다.
이때 saddle point 주변에서 기울기가 0에 수렴하기 때문에 업데이트 속도가 매우 느려진다는 큰 문제가 발생한다.
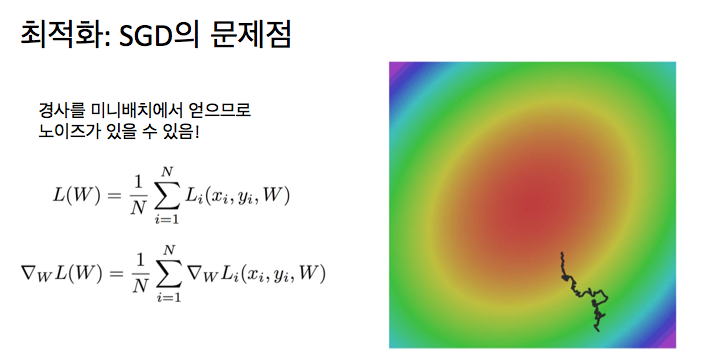
우리는 확률적 경사 하강법을 사용하고 있다는 것을 인지해야 한다.
batch단위에 대해서 경사하강법을 적용하고 있기 때문에 약간의 노이즈를 포함하여 추정하는 것이다.
경사 추정의 노이즈가 있으면 바닐라 SGD는 공간을 이리저리 다니다가 최소를 향해 가기까지 오랜 시간이 걸릴 수 있다.
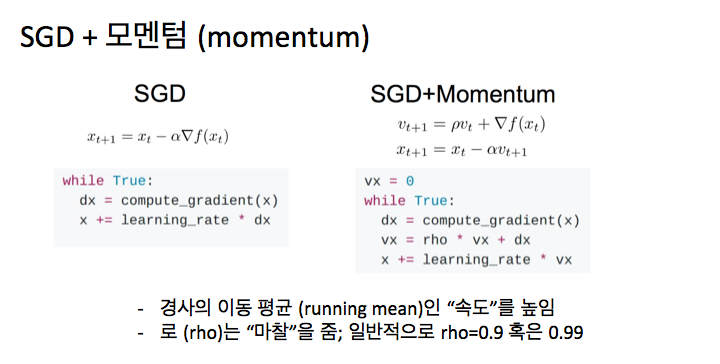
여기에는 이 문제를 해결해주는 간단한 방법이 있다.
바로 모멘텀을 사용하는 것이다.
현재의 경사에 대한 마찰을 주고 경사에 더하는 방식이다.
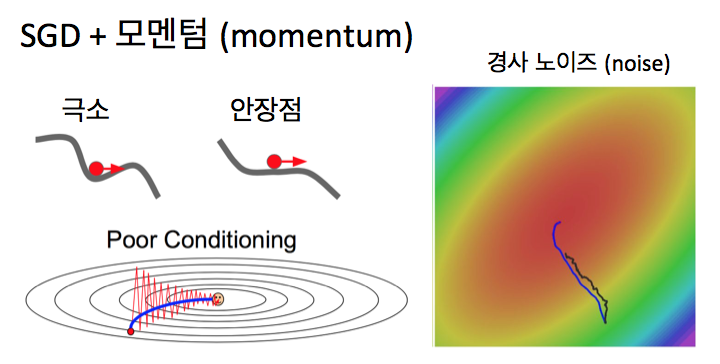
이 간단한 방식으로 언덕을 내려가는 공이 속도를 더해 극소지점, 안장점을 통과할 수 있는 것이다.
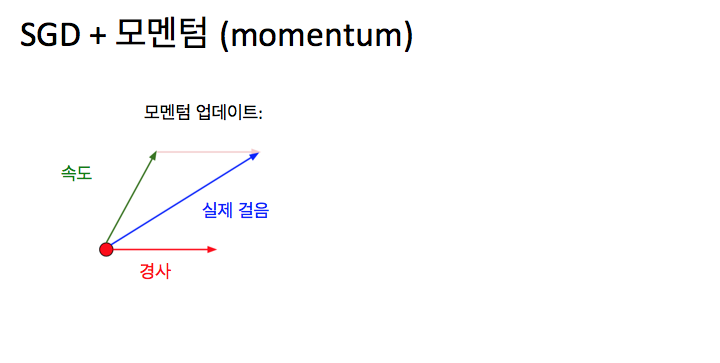
SGD + 모멘텀을 할 때, 생각해 볼 수 있는 그림이 하나가 있다.
모멘텀을 활용하여 가중치를 업데이트 한다면 경사만을 고려하지 않고 이전의 속도도 고려하여 이 둘의 가중치의 평균에 따라서 움직이게 되는 것이다.
이 방식은 경사 추정 방식에서 약간의 노이즈를 극복하도록 만든다.
'CS231n' 카테고리의 다른 글
| [cs231n] 7강 신경망 훈련하기 (3/4) (0) | 2025.06.21 |
|---|---|
| [cs231n] 7강 신경망 훈련하기 (2/4) (1) | 2025.06.21 |
| [cs231n] 6강 신경망 훈련하기-(2/2) (3) | 2025.06.19 |
| [cs231n] 6강 신경망 훈련하기-(1/2) (1) | 2025.06.17 |
| [cs231n] 5강 합성곱 신경망 (0) | 2025.06.17 |


